A web profunda (Deep Web) pode soar misteriosa, mas você provavelmente a usou várias vezes hoje sem perceber. Grande parte dela é composta por serviços e informações online comuns que não aparecem nos resultados de busca.
Ao contrário da web escura (Dark Web), a web profunda não exige software especializado nem ferramentas de anonimato. Abaixo explicamos o que ela inclui, como funciona e por que essa distinção importa.
O que é a web profunda?
A web profunda é qualquer conteúdo na web que os mecanismos de busca não indexam, como sua caixa de entrada de e‑mail ou o histórico de pedidos de uma loja online. Não se trata de uma rede ou tecnologia separada — a maior parte das pessoas a utiliza diariamente.
Sua caixa de entrada conta como conteúdo da web profunda porque os buscadores não conseguem alcançá‑la. A definição de web profunda está relacionada à visibilidade e ao acesso por pesquisa, e não a se uma página é suspeita ou ilegal.
- A maioria das pessoas usa a web profunda diariamente sem precisar de software especial ou conhecimentos técnicos.
- Acessar a web profunda é legal, embora a lei se aplique ao que você fizer lá.
- A web escura é uma pequena parte deliberadamente oculta da web profunda que normalmente exige Tor.
- Uma página que os buscadores não encontram pode não ser segura, portanto conteúdo privado ainda precisa de senha.
- Phishing e reutilização de senhas são formas comuns de invasão de contas da web profunda.
Web de superfície vs. web profunda
Os motores de busca usam rastreadores para descobrir páginas e decidir quais incluir em seus índices. A web de superfície (Surface Web) consiste em conteúdo publicamente acessível que foi indexado, enquanto a web profunda inclui conteúdo que não foi indexado.
Um único site pode conter ambos. Por exemplo: as páginas de produtos de uma loja online podem aparecer nos resultados de busca, enquanto seu histórico de pedidos pessoal só é acessível após você fazer login.
Como funciona a web profunda?
A web profunda funciona por meio de barreiras que impedem os rastreadores de encontrar ou ler uma página. Essa barreira pode ser uma tela de login, um paywall ou uma instrução do proprietário do site para ignorar a página.
Os sites usam esses mecanismos sem qualquer tecnologia especial, e algumas páginas têm mais de um motivo para ficar fora do índice. Estes são os motivos mais comuns pelos quais um rastreador deixa de localizar uma página:
|
Barreira |
Exemplo |
Por que os buscadores deixam de fora |
|---|---|---|
|
Logins e controles de acesso |
Sua conta de e‑mail ou um sistema corporativo |
Um rastreador não tem nome de usuário nem senha, então ele para na página de login. |
|
Paywalls e assinaturas |
Sites de notícias e serviços de streaming |
O conteúdo completo pode exigir assinatura, embora os mecanismos de busca por vezes indexem páginas com paywall ou trechos do conteúdo. |
|
Conteúdo gerado por banco de dados |
Resultados de busca de voos |
Alguns resultados só são gerados depois que o usuário envia uma consulta, tornando‑os difíceis de serem descobertos e indexados por mecanismos de busca padrão. |
|
Páginas sem links |
Um documento compartilhado por link direto |
Rastreadores encontram páginas seguindo links, e nenhuma outra página aponta para esta. |
|
Restrições para rastreadores |
Páginas que o proprietário do site pede para os motores de busca ignorarem |
Um arquivo robots.txt pode restringir o acesso dos rastreadores, enquanto a diretiva noindex instrui os buscadores a não incluir uma página nos resultados. Nenhuma dessas medidas protege informações privadas — os mecanismos de busca geralmente obedecem a esses pedidos, mas não há garantia de proteção. |
Um rastreador travará nesses pontos, mas pessoas com o login, link ou permissões adequadas ainda conseguem acessar. Quem encontrar o endereço de uma página sem links também pode entrar, e restrições para rastreadores são apenas solicitações que o site não consegue forçar. Para proteger conteúdo privado, sites dependem de senhas e permissões, e quem lida com dados sensíveis normalmente adiciona criptografia, de modo que qualquer coisa interceptada em trânsito fica mais difícil de ler.
Testado de forma independente e premiado pelos principais laboratórios do setor.



Qual é a diferença entre a web profunda e a web escura?
O conteúdo da web profunda fica fora dos resultados de busca por vários motivos, incluindo exigência de login, restrições de acesso e limitações técnicas. A web escura é uma parte muito menor e intencionalmente oculta da web profunda que utiliza redes de anonimato para ajudar a ocultar a identidade de usuários e operadores de sites.
Serviços da web escura costumam usar endereços.onion e exigir software especializado como o Tor Browser para acessá‑los. Esses serviços podem atender necessidades legítimas de privacidade, mas também podem ser usados para atividades ilegais.
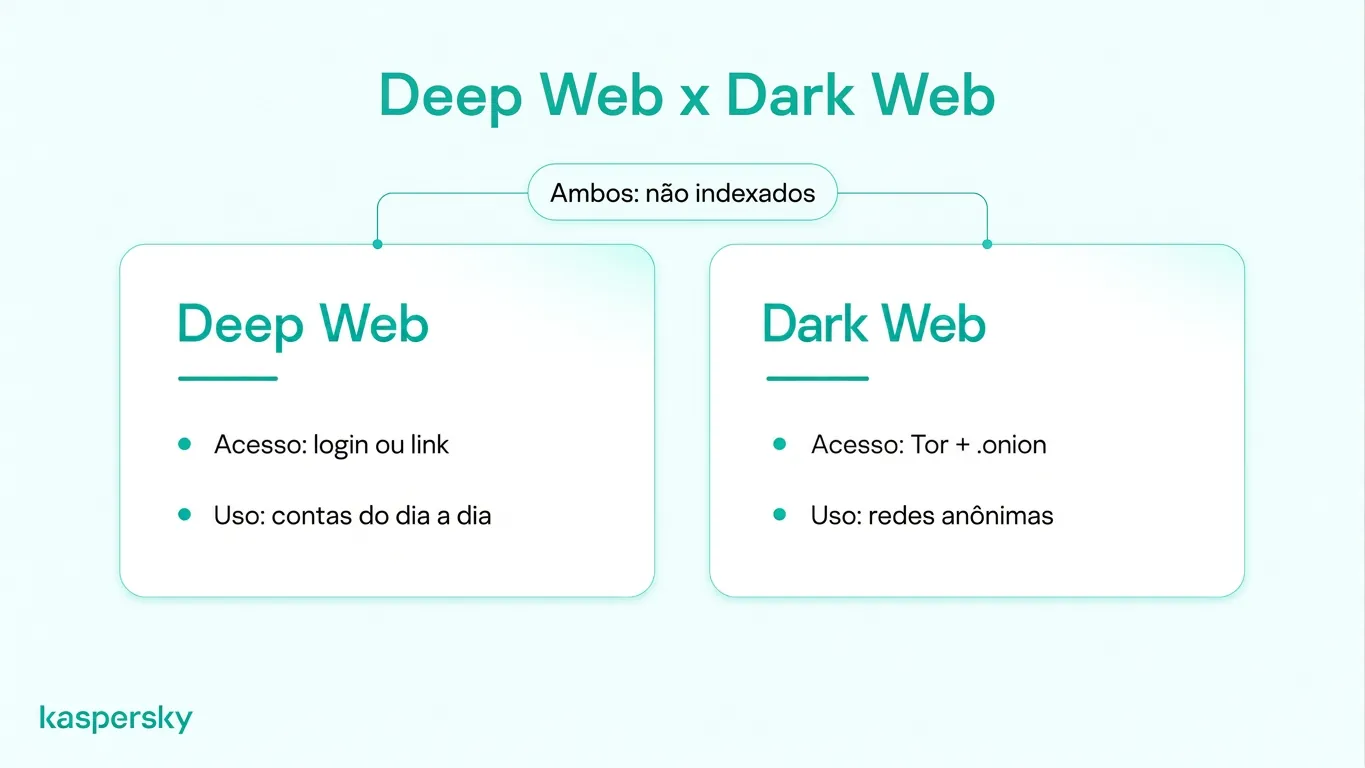
Esta tabela mostra onde as duas se diferenciam:
|
|
Web profunda |
Web escura |
|---|---|---|
|
Indexada por mecanismos de busca |
Não |
Não |
|
Quem pode alcançá‑la |
Qualquer pessoa com o link certo ou credenciais de acesso |
Usuários de redes de anonimato especializadas |
|
Conteúdo típico |
E‑mail, internet banking, armazenamento em nuvem, assinaturas, bancos de dados |
Fóruns anônimos e serviços.onion, alguns legítimos e outros criminosos |
|
Finalidade |
Conteúdo privado, restrito ou não indexado |
Ocultar a identidade de operadores e visitantes de sites |
|
Requisitos de acesso |
Um navegador padrão mais login, URL direto ou consulta de pesquisa |
Tor ou software similar mais o endereço.onion do site |
O que você pode encontrar na web profunda?
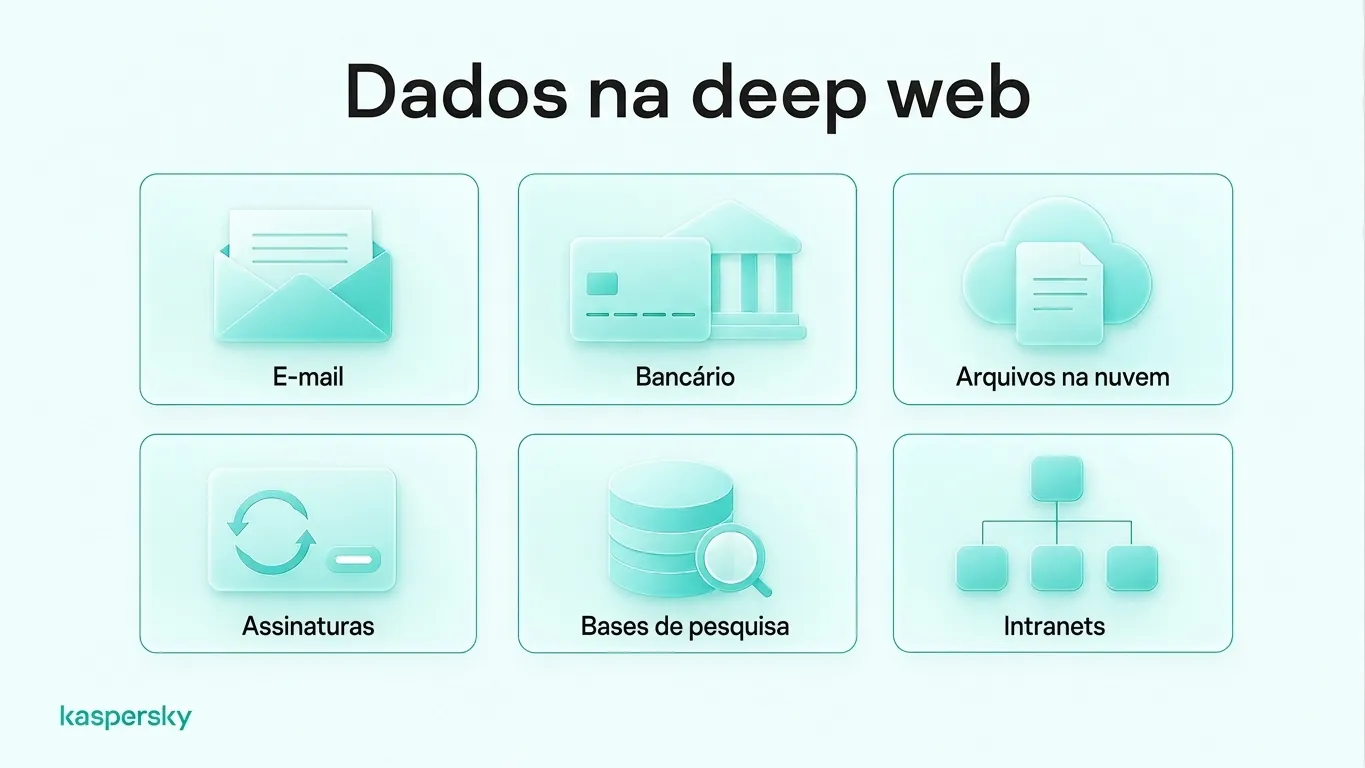
A web profunda contém uma grande variedade de informações cotidianas e especializadas, desde contas pessoais e serviços por assinatura até bases de pesquisa e registros organizacionais. Alguns recursos exigem login ou permissão, enquanto outros simplesmente não são incluídos nos resultados de busca padrão.
Serviços pessoais e do dia a dia
Sua caixa de entrada de e‑mail, internet banking, armazenamento em nuvem, portal de paciente e painéis de conta só abrem após fazer login, então os mecanismos de busca não conseguem alcançá‑los. Publicações em redes sociais que você compartilhou apenas com amigos ficam restritas por permissões, e notícias ou serviços de streaming mostram o conteúdo completo somente depois que você pagar.
Bancos de dados e recursos restritos
Universidades, empresas e órgãos governamentais também armazenam grande volume de informação na web profunda. Isso inclui bases de periódicos acadêmicos, intranets corporativas, arquivos digitais e documentos internos.
Parte dessa informação só aparece quando você a pesquisa. Um portal de processos judiciais pode conter milhões de casos, mas constrói a página de resultados apenas quando você busca dentro do próprio portal. Bibliotecas de periódicos universitários funcionam de forma semelhante e muitas exigem login antes de permitir a leitura do acervo.
Como você acessa a web profunda?
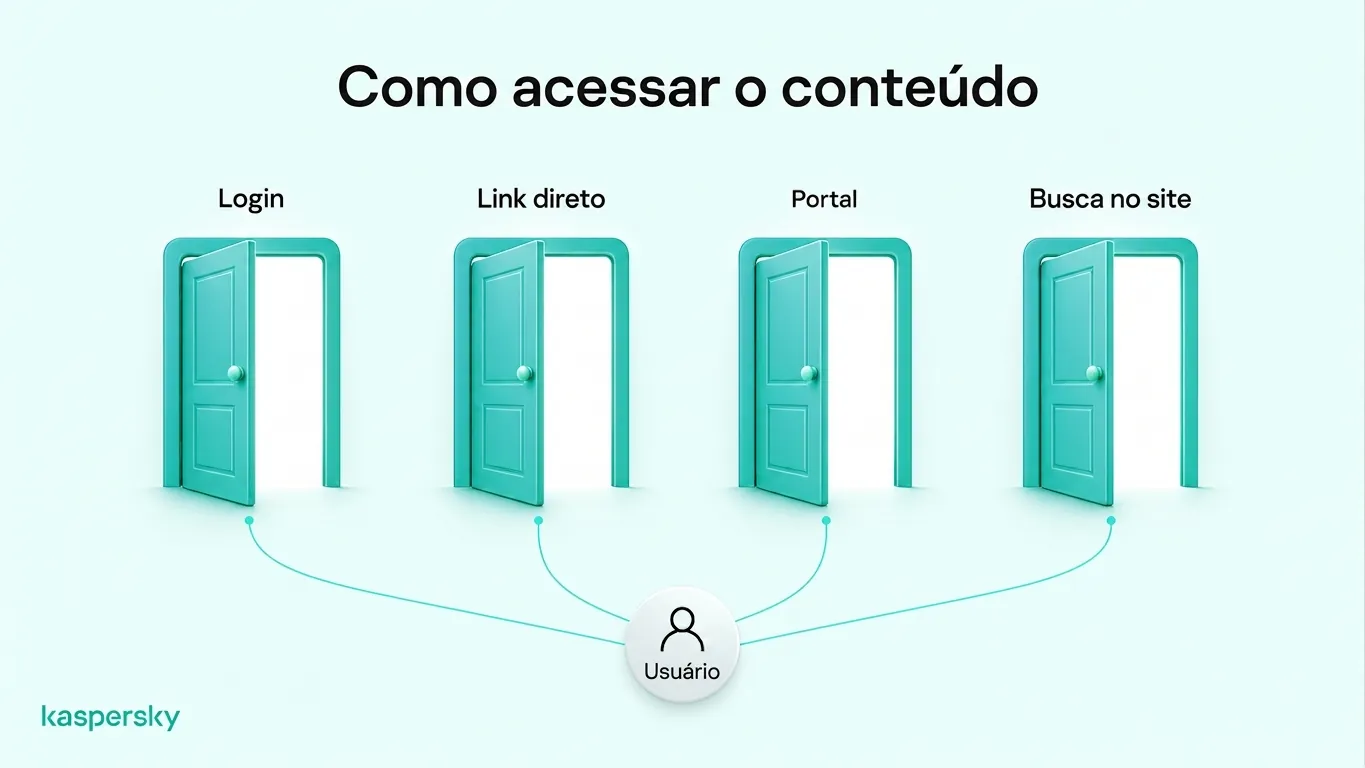
Você não precisa de software especial para acessar a web profunda. O navegador ou app que já usa abrirá a maior parte dela assim que você fizer login ou seguir o link correto.
Como não existe um site, navegador ou rede únicos para entrar na web profunda, o modo de acesso depende do que você quer alcançar:
- Suas contas: fazer login no seu e‑mail ou internet banking.
- Arquivos compartilhados: abrir um link direto para uma pasta privada em nuvem que alguém compartilhou com você.
- Portais privados: entrar na intranet do trabalho ou na biblioteca da universidade.
- Bases pesquisáveis: usar o formulário de busca do próprio site, como catálogo de biblioteca ou ferramenta de reserva de voos.
Tor e ferramentas de anonimato similares não são necessárias para serviços comuns da web profunda. O Tor Browser serve para acessar serviços.onion na web escura, que não estão disponíveis por conexões padrão de navegador.
A web profunda é segura e legal?
A web profunda não é inerentemente ilegal nem perigosa. A maioria das pessoas usa serviços legítimos da web profunda todos os dias, como e‑mail, bancos e contas privadas online. No entanto, os mesmos riscos de segurança presentes em outros pontos da internet — como phishing, malware e vazamentos de dados — continuam a valer.
O termo “web profunda” descreve apenas como o conteúdo é encontrado e acessado, não se é ou não legítimo ou confiável. O que você fizer ali continua sujeito às leis, que variam conforme o país. Entrar na sua própria caixa de e‑mail é legal; acessar a conta de outra pessoa sem permissão não é.
Uma página também não é necessariamente mais arriscada só porque os buscadores a ignoram. Seu banco, por exemplo, geralmente protege as páginas da sua conta com mais cuidado do que a página pública inicial.
Invasores miram contas da web profunda com os mesmos métodos usados em outras partes da internet:
- Phishing e golpes: páginas de login falsas e mensagens que imitam seu banco ou provedor de e‑mail para capturar sua senha.
- Malware: downloads ou anexos maliciosos que instalam softwares capazes de registrar o que você digita.
- Roubo de credenciais: senhas furtadas de um serviço podem ser testadas em suas outras contas.
- Vazamentos de dados: um serviço que você usa pode ser invadido, expondo seus dados sem que você tenha culpa.
E‑mails, registros financeiros e informações médicas costumam ser armazenados em serviços privados da web profunda. Isso não significa que tenham sido vazados ou comprometidos. Ainda assim, falhas de segurança, acessos não autorizados e exposições acidentais podem colocar essas informações em risco.
Como ficar seguro ao usar serviços da web profunda?
Muitos ataques começam pela forma como você faz login ou pelo que você baixa; por isso, estes hábitos ajudam a manter suas contas seguras:
- Use uma senha forte e única para cada conta, assim um vazamento em um serviço tem menos chance de abrir os outros. Um gerenciador de senhas pode criar e lembrar essas senhas para você.
- Ative a autenticação multifator, que pede uma segunda confirmação, como um código no celular. Uma senha roubada sozinha pode não ser suficiente para entrar. Comece pela sua conta de e‑mail, pois ela costuma ser usada para redefinir outras senhas.
- Verifique o endereço antes de fazer login, porque páginas de phishing costumam copiar telas de acesso reais. Digite o endereço manualmente ou use um favorito em vez de seguir links em e‑mails ou mensagens.
- Mantenha o navegador, sistema operacional e software de segurança atualizados, já que atualizações frequentemente corrigem falhas exploradas por invasores.
- Baixe arquivos e abra anexos apenas de fontes confiáveis, e forneça a cada site apenas as informações pessoais necessárias ao serviço.
O Kaspersky Premium inclui proteção contra vírus e phishing, um gerenciador de senhas e alertas caso suas senhas apareçam em um vazamento de dados.
Artigos relacionados:
Produtos recomendados:
FAQs
A web profunda é real?
Sim. A web profunda é real, mas não é um lugar oculto nem uma internet separada. É conteúdo da web que os mecanismos de busca não indexam, como páginas de conta, conteúdo por assinatura e bases de dados privadas.
Qual o tamanho da web profunda?
Ninguém consegue medir a web profunda com precisão. Conteúdo que os buscadores não conseguem indexar é difícil de contabilizar, então as estimativas variam bastante. É provavelmente muito maior que a web de superfície, porque inclui todas as contas privadas.
A web profunda é anônima?
Normalmente não. A maior parte dos serviços da web profunda exige que você faça login, então o serviço sabe qual conta está sendo usada. A HTTPS ajuda a proteger seus dados em trânsito, mas não oculta sua identidade daquele serviço.
Qualquer pessoa pode acessar a web profunda?
Sim. Parte do conteúdo da web profunda é acessível por links diretos, enquanto contas privadas, serviços por assinatura e bases restritas exigem credenciais de login ou permissão. A maior parte do conteúdo da web profunda pode ser acessada com um navegador padrão.